因子是“把价格、成交量等原始数据加工成一个可排序的分数”。因子遗传让算法在历史数据里自动尝试大量公式,再把有效的公式组合起来。
它到底在做什么
假设你每天都给一篮子的币打分,分数高的多买、分数低的少买。因子就是打分公式,例如“5 日均线减 20 日均线”。
人工想公式很慢,因子遗传让算法自动组合加减乘除、均值、相关性、波动率等操作,评估每个公式对未来收益的预测能力,把表现好的留下来继续变异。
算法负责“发明公式”,你负责“判断它是不是在自欺欺人”。
前置数据
| 准备项 | 怎么选 |
|---|---|
| 标的池 | 建议至少 10 个流动性较好的标的。因子比较的是同一批标的之间的相对强弱。 |
| 训练区间 | 用来搜索公式的历史区间,应该足够长。 |
| 测试区间 | 必须晚于训练区间,且不参与搜索。 |
| 预测周期 | 预测未来多少根 K 线的收益。周期越长,噪声越少,但样本也越少。 |
| 数据 | 先到数据仓库确认交易对、周期和覆盖范围。 |
新建任务
-
打开因子遗传
进入量化center → 因子挖掘 → 因子遗传,点击“新建任务”。
-
填写标的池
每行一个标的。输入后系统会检查数据是否可用;无效标的会被标出。
-
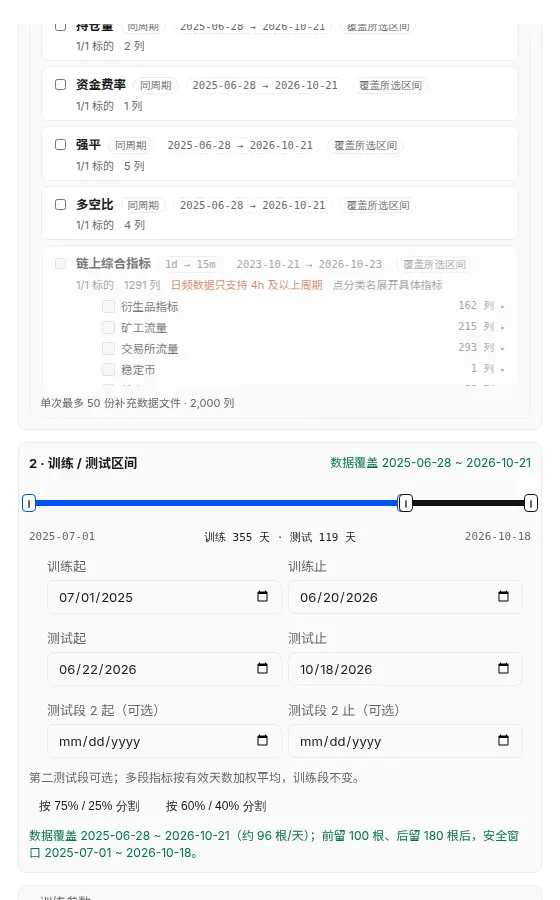
划出训练段和测试段
训练段用来搜索,测试段用来检验。两者不要重叠,测试段尽量晚于训练段。
你应该看到:页面显示训练天数、测试天数和数据覆盖范围。
-
设置预测周期和搜索规模
第一次先用较小步数,确认流程和耗时;不要一上来就跑很大的任务。
-
选择挖掘方式
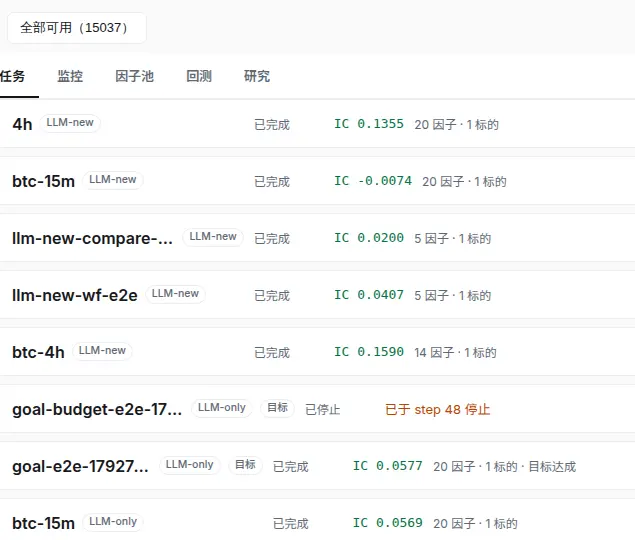
界面会提供强化学习、遗传算法、LLM 辅助等不同方式。第一次建议先用默认方式,熟悉后再比较差异。
监控与过拟合
任务启动后,监控页会同时画训练曲线和测试曲线。两条线的关系比单条曲线的高低更重要。
| 形态 | 含义 | 建议 |
|---|---|---|
| 训练涨,测试也涨 | 相对健康 | 继续观察,别急着扩大规模 |
| 训练涨,测试走平 | 开始过拟合 | 停止或提前导出快照 |
| 训练涨,测试下降 | 明显过拟合 | 停止,回看较早的快照 |
| 两条线都不动 | 搜索没有进展 | 检查数据、标的池和参数 |
反复根据测试段调参,会让测试段也变成训练集。真正的样本外验证需要留出一段从未看过的数据。
因子池
因子池是当前被选中的公式组合。它有几个常用视图:
- 快照轴:回看任意历史时刻的池子,比较不同阶段的组合。
- 因子表:每个公式的权重和单因子表现。
- 相似度热力图:两个因子越相似,冗余越大。
- 时间线:谁被加入、谁被淘汰,以及组合强度的变化。
- 导出:下载当前快照,或生成策略包。
权重反映相对贡献,不要求加起来等于 100%。相似度高的因子即使权重不低,也可能没有提供新增信息。
单因子详情
| 指标 | 怎么看 |
|---|---|
| IC / Rank IC | 预测力。绝对值长期稳定比单次高低更重要。 |
| 日度 IC 序列 | 看方向是否稳定,避免只看平均值。 |
| 分位数收益 | 把标的按因子值分组,收益是否单调递增或递减。 |
| 相关性 | 与池内其它因子是否高度相似。 |
判断一个因子,至少同时满足:测试段方向稳定、分位数大致单调、与现有因子不雷同。
回测与生成策略
满意的组合可以直接提交回测,或生成策略包。回测前确认:
- 用的是测试段或样本外区间,而不是训练段。
- 手续费、滑点和资金规模设置合理。
- 组合在多个快照上都不是只靠某一个因子。
生成的策略仍然要在工作台里构建、在实验室里回测,并通过模拟盘验证。
常见错误
| 现象 | 可能原因 | 处理 |
|---|---|---|
| 任务跑太久 | 标的、步数或数据量太大 | 先用小规模任务熟悉流程 |
| IC 很低 | 标的池太小、预测周期不合适 | 增加标的、调整周期或换数据 |
| 测试集明显变差 | 过拟合 | 停止,导出较早快照,保留样本外数据 |
| 因子高度相似 | 搜索空间重复 | 保留一个,删除冗余因子 |
| 提示资源不足 | 并发任务或机器负载高 | 减少并发,错峰运行 |
常见问题
-
因子挖掘要跑多久?
取决于标的数量、数据量、步数和机器负载,可能从几十分钟到数小时。第一次先用较小步数和较短区间熟悉流程,确认有效后再扩大。
-
IC 多少算好?
没有统一标准,但绝对值长期稳定比单次高低更重要。先看测试段是否同向,再看分位数是否单调、与池内因子是否高度相似。
-
训练曲线很好、测试曲线很差怎么办?
这通常说明过拟合。停止训练,保留较早的快照,并检查标的池、区间和参数是否被反复针对测试段调整。
打开因子遗传
先建一个小任务,重点观察训练曲线和测试曲线是否同向。